4 вересня 2026 р.
Побудова HA Kubernetes кластера
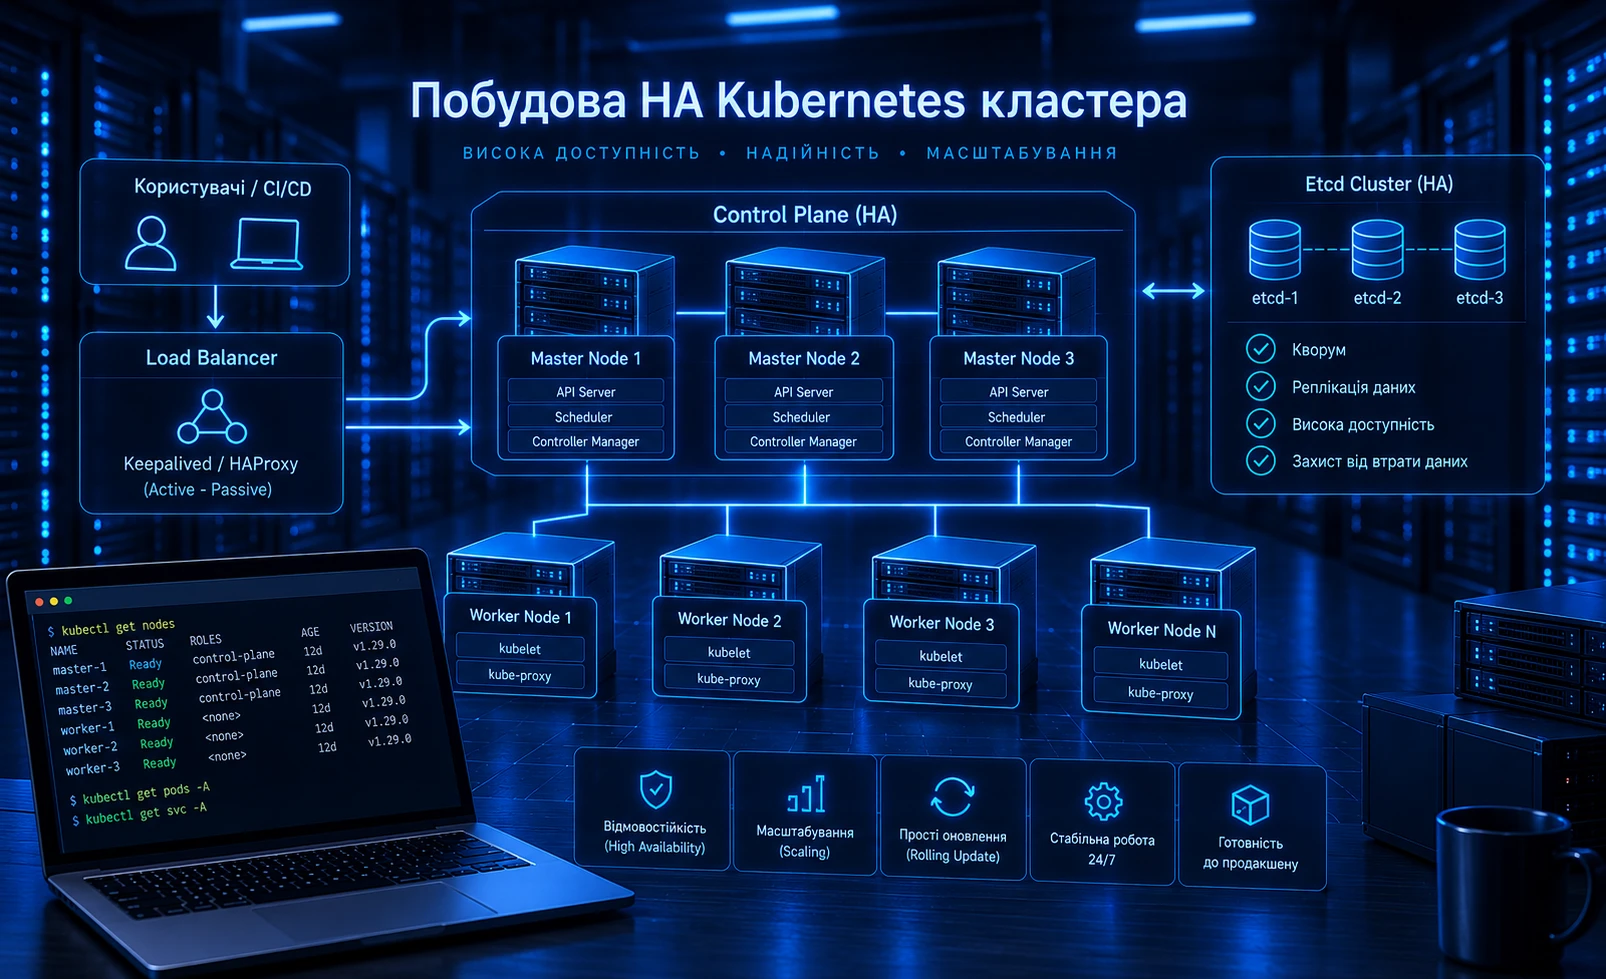
Один control-plane вузол зручний для лабораторії, але залишається єдиною точкою відмови: разом із ним зникає Kubernetes API, scheduler, controller-manager і локальний etcd. Уже запущені контейнери можуть певний час працювати, проте кластер не зможе повноцінно реагувати на збої, створювати нові Pod або змінювати бажаний стан.
У цій інструкції побудуємо HA Kubernetes кластер через kubeadm: три control-plane вузли зі stacked etcd, кілька worker-вузлів і спільний TCP endpoint перед kube-apiserver. Така топологія потребує менше окремих серверів, ніж external etcd, і підходить для більшості невеликих та середніх платформ. Для систем із жорсткішими вимогами до ізоляції etcd можна винести на три окремі машини, але це збільшить кількість вузлів і операційне навантаження.
Якщо потрібні проєктування, впровадження та подальший супровід платформи, команда ITheal надає DevOps-послуги. Нижче зосередимося на практичній ручній конфігурації, яку легко перенести в Ansible або інший засіб автоматизації.
Архітектура HA-кластера та мережевий план
Для кворуму etcd потрібна непарна кількість учасників. Три control-plane вузли дозволяють пережити втрату одного учасника: кворум зберігають два з трьох. Втрата двох одночасно зупинить запис до etcd, тому HA не замінює резервні копії й рознесення вузлів між різними фізичними хостами або зонами відмови.
Приклад адресації:
lb-01       10.20.0.10
lb-02       10.20.0.11
API VIP     10.20.0.20  ha-k8s.internal
cp-01       10.20.0.21
cp-02       10.20.0.22
cp-03       10.20.0.23
worker-01   10.20.0.31
worker-02   10.20.0.32
Pod CIDR    10.244.0.0/16
Service CIDR 10.96.0.0/12
DNS-ім’я `ha-k8s.internal` має вказувати на VIP балансувальників. Саме цей endpoint, а не IP першого control-plane вузла, потрібно передати kubeadm під час початкової ініціалізації. Перетворення кластера, створеного без стабільного `controlPlaneEndpoint`, на HA пізніше суттєво ускладнюється.
Балансувальник працює на TCP-рівні й передає порт `6443` на всі API servers. Мінімальна конфігурація HAProxy на обох LB-вузлах виглядає так:
frontend kubernetes_api
    bind *:6443
    mode tcp
    option tcplog
    default_backend kubernetes_control_plane

backend kubernetes_control_plane
    mode tcp
    option tcp-check
    balance roundrobin
    server cp-01 10.20.0.21:6443 check
    server cp-02 10.20.0.22:6443 check
    server cp-03 10.20.0.23:6443 check
Перевірте конфігурацію перед reload:
sudo haproxy -c -f /etc/haproxy/haproxy.cfg
sudo systemctl reload haproxy
sudo ss -lntp | grep 6443
Два HAProxy без спільного VIP усе одно залишають залежність від однієї адреси. VIP можна керувати Keepalived/VRRP, мережевим балансувальником датацентру або cloud TCP load balancer. Не розміщуйте обидва LB на одному hypervisor. До запуску kubeadm перевірте з кожного вузла, що `ha-k8s.internal` резолвиться в потрібну адресу. TCP check балансувальника до API до ініціалізації очікувано буде неуспішним.
Підготовка всіх Kubernetes-вузлів
Виконайте підготовку на `cp-01`, `cp-02`, `cp-03` і кожному worker. Задайте унікальні hostname, синхронізуйте час через chrony або systemd-timesyncd, налаштуйте статичні адреси та взаємне DNS-розв’язання. Swap вимкніть, якщо ви свідомо не налаштовуєте підтримку swap у kubelet:
sudo swapoff -a
sudo sed -ri '/\sswap\s/s/^#?/#/' /etc/fstab

sudo modprobe overlay
sudo modprobe br_netfilter

sudo tee /etc/modules-load.d/kubernetes.conf >/dev/null <<'EOF'
overlay
br_netfilter
EOF

sudo tee /etc/sysctl.d/99-kubernetes.conf >/dev/null <<'EOF'
net.bridge.bridge-nf-call-iptables  = 1
net.bridge.bridge-nf-call-ip6tables = 1
net.ipv4.ip_forward                 = 1
EOF

sudo sysctl --system
Встановіть containerd з офіційного репозиторію вашої ОС або постачальника пакетів. Не змішуйте навмання конфігурацію containerd 1.x і 2.x: шляхи секцій CRI відрізняються. Детальна перевірка CRI, socket і cgroup driver наведена у статті Containerd замість Docker.
Для systemd-систем kubelet і containerd мають використовувати cgroup driver `systemd`. Після налаштування перевірте runtime:
sudo systemctl enable --now containerd
sudo systemctl --no-pager status containerd
sudo crictl --runtime-endpoint unix:///run/containerd/containerd.sock info
Далі встановіть `kubelet`, `kubeadm` і `kubectl` з офіційного Kubernetes package repository для обраної minor-версії. Не копіюйте номер версії з чужого прикладу: спочатку визначте підтримуваний реліз і однаково зафіксуйте його на всіх вузлах.
export K8S_MINOR='v1.37'

curl -fsSL "https://pkgs.k8s.io/core:/stable:/${K8S_MINOR}/deb/Release.key" \
  | sudo gpg --dearmor -o /etc/apt/keyrings/kubernetes-apt-keyring.gpg

echo "deb [signed-by=/etc/apt/keyrings/kubernetes-apt-keyring.gpg] https://pkgs.k8s.io/core:/stable:/${K8S_MINOR}/deb/ /" \
  | sudo tee /etc/apt/sources.list.d/kubernetes.list

sudo apt-get update
sudo apt-get install -y kubelet kubeadm kubectl
sudo apt-mark hold kubelet kubeadm kubectl

kubeadm version
kubelet --version
kubectl version --client
Значення `v1.37` тут є прикладом для поточної гілки документації. Перед розгортанням звірте підтримувані релізи Kubernetes, сумісність CNI та containerd. Minor-версії компонентів control plane не повинні випадково розходитися. Відкрийте між вузлами лише потрібні порти: TCP `6443` для API, `2379-2380` між членами etcd, `10250`, `10257`, `10259` для control plane, а також порти обраного CNI. Правила для worker залежать від мережевого плагіна і способу публікації сервісів.
Ініціалізація першого control-plane вузла
На `cp-01` створіть kubeadm-конфігурацію. Підставте фактичну patch-версію, яку показує `kubeadm version`, та IP саме цього вузла:
apiVersion: kubeadm.k8s.io/v1beta4
kind: InitConfiguration
localAPIEndpoint:
  advertiseAddress: 10.20.0.21
  bindPort: 6443
nodeRegistration:
  criSocket: unix:///run/containerd/containerd.sock
---
apiVersion: kubeadm.k8s.io/v1beta4
kind: ClusterConfiguration
kubernetesVersion: v1.37.0
controlPlaneEndpoint: ha-k8s.internal:6443
networking:
  podSubnet: 10.244.0.0/16
  serviceSubnet: 10.96.0.0/12
---
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
cgroupDriver: systemd
Збережіть файл як `/root/kubeadm-ha.yaml`. Перед init перевірте доступність VIP та завантаження images:
getent hosts ha-k8s.internal
nc -vz ha-k8s.internal 6443 || true
sudo kubeadm config images pull --config /root/kubeadm-ha.yaml
sudo kubeadm init --config /root/kubeadm-ha.yaml --upload-certs
`nc` може повернути помилку до появи першого API server, але DNS і маршрут до VIP вже повинні працювати. Після успішного init збережіть обидві команди `kubeadm join`: окрему для control plane з `--control-plane --certificate-key` та окрему для workers. Certificate key, завантажений kubeadm, за замовчуванням має обмежений строк дії, тому не відкладайте приєднання інших control-plane вузлів і не публікуйте команди у чатах або CI logs.
Налаштуйте kubectl для адміністратора:
mkdir -p "$HOME/.kube"
sudo cp -i /etc/kubernetes/admin.conf "$HOME/.kube/config"
sudo chown "$(id -u):$(id -g)" "$HOME/.kube/config"

kubectl get nodes
kubectl get pods -A
Одразу встановіть один CNI, сумісний із вашим Pod CIDR. Не застосовуйте два мережеві plugins одночасно. Команду інсталяції беріть із документації конкретного release CNI, перевіряйте checksum або digest manifest і зберігайте версію у Git. Якщо зміни платформи проходять через керований CI/CD pipeline, manifest або Helm values мають бути reviewable та відтворюваними.
kubectl apply -f ./cni-manifest-reviewed.yaml
kubectl -n kube-system get pods -o wide
kubectl get nodes -o wide
Приєднання вузлів і перевірка відмовостійкості
Приєднуйте `cp-02` і `cp-03` по одному, щоразу чекаючи готовності попереднього вузла. Команда з виводу init має приблизно такий вигляд:
sudo kubeadm join ha-k8s.internal:6443 \
  --token <bootstrap-token> \
  --discovery-token-ca-cert-hash sha256:<ca-hash> \
  --control-plane \
  --certificate-key <certificate-key> \
  --cri-socket unix:///run/containerd/containerd.sock
Якщо certificate key протермінований, на працюючому control-plane вузлі створіть новий:
sudo kubeadm init phase upload-certs --upload-certsWorkers приєднуються без `--control-plane` і `--certificate-key`:
sudo kubeadm join ha-k8s.internal:6443 \
  --token <bootstrap-token> \
  --discovery-token-ca-cert-hash sha256:<ca-hash> \
  --cri-socket unix:///run/containerd/containerd.sock
Якщо join-команду втрачено, створіть новий token і надрукуйте базову команду на control-plane вузлі:
sudo kubeadm token create --print-join-commandПеревірте nodes, системні Pod, endpoints API та склад etcd:
kubectl get nodes -o wide
kubectl get pods -n kube-system -o wide
kubectl get endpoints kubernetes -o yaml
kubectl get --raw='/readyz?verbose'
Для stacked etcd виконайте endpoint status усередині одного etcd Pod, використовуючи його сертифікати:
ETCD_POD="$(kubectl -n kube-system get pods -l component=etcd \
  -o jsonpath='{.items[0].metadata.name}')"

kubectl -n kube-system exec "$ETCD_POD" -- sh -c \
  'ETCDCTL_API=3 etcdctl endpoint status --cluster -w table \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt \
  --key=/etc/kubernetes/pki/etcd/healthcheck-client.key'
У таблиці мають бути три endpoints і один leader. Тепер перевірте не лише зелені статуси, а й відмову. Створіть тестовий Deployment з кількома replicas, переконайтеся, що Pod розміщені на різних workers, потім у погоджене maintenance window вимкніть `cp-01` або зупиніть його kubelet. Kubectl через `ha-k8s.internal` має продовжувати відповідати, а новий leader etcd — бути обраний. Після повернення вузла перевірте, що всі etcd members синхронізувалися.
Регулярно створюйте зашифровані snapshot etcd і копіюйте їх за межі control-plane вузлів. Приклад ручного snapshot:
sudo ETCDCTL_API=3 etcdctl snapshot save /srv/backup/etcd-$(date +%F-%H%M).db \
  --endpoints=https://127.0.0.1:2379 \
  --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/healthcheck-client.crt \
  --key=/etc/kubernetes/pki/etcd/healthcheck-client.key

sudo etcdctl snapshot status /srv/backup/etcd-*.db -w table
Не обмежуйтеся фактом створення файла: регулярно тестуйте restore в ізольованому середовищі. Snapshot etcd не копіює дані з PersistentVolume, зовнішніх баз або registry; для них потрібні окремі backup-процедури.
Типові помилки під час побудови HA-кластера
Найчастіша помилка — вказати IP `cp-01` замість стабільного endpoint балансувальника. Сертифікат API і kubeconfig тоді прив’язані до неправильної точки входу, а падіння першого вузла позбавляє HA сенсу. До init перевірте DNS, VIP, firewall і маршрут з усіх control-plane та worker-вузлів.
Друга помилка — назвати HA конфігурацію з трьома control-plane вузлами, але залишити один HAProxy. Резервуйте весь ланцюжок: DNS/VIP, балансувальники, живлення, hypervisors, switches і storage. Два VM на одному фізичному сервері не захищають від його відмови.
Третя помилка — втратити etcd quorum через одночасне обслуговування двох із трьох вузлів. Оновлюйте control plane послідовно, контролюйте health після кожного кроку й не виконуйте паралельний reboot більшості members. Перед upgrade створюйте перевірений snapshot.
Також часто забувають узгодити Pod CIDR із CNI, відкривають не всі міжвузлові порти або залишають різні cgroup drivers. Симптоми — `NotReady`, CNI sandbox errors, CoreDNS у `Pending`, timeout під час join. Починайте діагностику з `journalctl -u kubelet`, `crictl info`, статусу containerd, CNI logs і мережевої перевірки конкретного порту.
Не копіюйте `/etc/kubernetes/pki` цілком між вузлами. kubeadm із `--upload-certs` передає лише потрібні shared certificates, а node-specific ключі створюються локально. Зберігайте `admin.conf`, bootstrap tokens і certificate key як секрети та регулярно переглядайте доступи.
Висновок
Практичний HA Kubernetes кластер починається не з трьох копій kube-apiserver, а зі стабільної точки входу та правильно визначених доменів відмови. Для базової production-топології потрібні щонайменше три control-plane вузли зі stacked etcd, резервований TCP load balancer, кілька workers, сумісні containerd і CNI, синхронізація часу та контрольований firewall.
kubeadm спрощує PKI, bootstrap і приєднання вузлів, але не перевіряє всю платформу замість адміністратора. Після інсталяції потрібно протестувати втрату LB і одного control-plane вузла, створення нових workloads, DNS та network policy, а також відновлення etcd зі snapshot. Лише успішний failover і перевірений restore показують, що схема справді витримує відмову.
Фіксуйте kubeadm config, CNI manifests, версії пакетів і процедури upgrade у системі контролю версій. Оновлюйте вузли по одному, не втрачайте quorum, зберігайте backup поза кластером і повторюйте аварійні навчання. Тоді HA буде відтворюваною операційною властивістю, а не лише схемою з трьома серверами.